
Cet article facilite l'interprétation des tableaux affichés par les logiciels de surveillance de la santé des disques durs comme CrystalDiskInfo, Smart Disk Checker, HD Tune, Hard Disk Sentinel, … En fin d'article la présentation de Smart Disk Checker a été rajoutée.
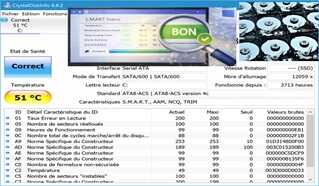
Sommaire
- 1. Qu’est-ce que S.M.A.R.T. ?
- 2. Les colonnes d'un tableau S.M.A.R.T.
- 3. Valeurs normalisées vs données brutes
- 4. L’état de santé global
- 5. Les attributs critiques à surveiller en priorité
- 6. Dictionnaire des attributs – disques durs HDD
- 7. Dictionnaire des attributs – SSD SATA
- 8. Les SSD NVMe : un format différent
- 9. Cas particuliers et points d'attention
- 10. Que faire en fonction de la situation affichée
- 11. Glossaire
- 12. Présentation de Smart_Disk_Checker
Note importante : S.M.A.R.T. est un outil d’alerte précoce et ce n'est pas une garantie. Le seul remède contre la perte de données est une sauvegarde régulière, idéalement selon la règle 3-2-1 : 3 copies, sur 2 supports différents, dont 1 hors site.
Voir aussi l'article : Anticiper les pannes des disques HDD et SSD
1. Qu’est-ce que S.M.A.R.T. ?
S.M.A.R.T. (Self-Monitoring, Analysis and Reporting Technology) est un système de surveillance qui est implémenté dans la quasi totalité des disques durs mécaniques et SSD. Le disque enregistre en permanence plusieurs compteurs concernant les erreurs, les températures, les heures de fonctionnement, l'usure…. Ces compteurs peuvent ensuite être exploités et interprétés par différents logiciels.
-
S.M.A.R.T. n’est pas véritable norme car chaque fabricant choisit les attributs qu'il suit et a ses propres formules de calcul et codes de valeur. Ainsi, 2 disques de marques différentes peuvent afficher un même attribut avec un sens qui peut être légèrement différent.
- S.M.A.R.T. ne prédit pas toutes les pannes. Une panne électronique soudaine (contrôleur, alimentation) peut survenir sans aucun signe préalable. Au contraire, un disque avec quelques secteurs réalloués peut fonctionner des années.
- Un tableau S.M.A.R.T. propre et un disque marqué comme "Bon" ne dispense jamais d'une sauvegarde
2. Les colonnes d'un tableau S.M.A.R.T.
Voici les colonnes que l’on retrouve dans la plupart des logiciels, les noms peuvent varier selon les logiciels :
|
Colonne |
Nom anglais |
Signification |
|
ID |
ID |
Numéro de l’attribut, affiché en hexadécimal (ex. 05, C5) dans CrystalDiskInfo, souvent en décimal ailleurs (ex. 5, 197). |
|
Attribut |
Attribute name |
Nom de l’attribut (ex. Reallocated Sectors Count). |
|
Valeur actuelle |
Current / Value |
Valeur normalisée par le fabricant, généralement sur une échelle de 1 à 100, 1 à 200 ou 1 à 253. Plus elle est haute, mieux c’est (dans l’immense majorité des cas). |
|
Pire |
Worst |
La valeur normalisée la plus basse jamais atteinte depuis la fabrication. |
|
Seuil |
Threshold |
Valeur limite fixée par le fabricant. Si Valeur actuelle ≤ Seuil, l’attribut est considéré comme en échec. Un seuil de 0 signifie que l’attribut est purement informatif et ne déclenche jamais d’échec. |
|
Données brutes |
Raw Values |
Le compteur réel (nombre de secteurs, d’heures, de degrés…). C’est souvent la colonne la plus parlante pour l’utilisateur. Affiché en hexadécimal par défaut dans CrystalDiskInfo. |
|
Type |
Type / Flags |
Pre-fail (pré-défaillance) : un passage sous le seuil annonce une panne imminente. Old age (vieillissement) : indique l’usure normale ; un dépassement signale la fin de vie, pas une panne immédiate. |
|
Mise à jour |
Updated |
Always (mis à jour en continu) ou Offline (mis à jour seulement lors des tests hors-ligne). |
|
Échec |
When_Failed |
(smartctl) Indique si l’attribut est en échec maintenant (FAILING_NOW) ou l’a été (In_the_past). - = jamais. |
Exemple de lecture d’une ligne
ID Attribut Actuelle Pire Seuil Données brutes
05 Reallocated Sectors Count 100 100 10 000000000000
→ Valeur normalisée 100 (parfaite), jamais descendue sous 100, seuil d’échec à 10, et 0 secteur réalloué dans les données brutes. Tout va bien.
ID Attribut Actuelle Pire Seuil Données brutes
05 Reallocated Sectors Count 097 097 10 0000000000A8
→ La valeur normalisée a baissé à 97, encore loin du seuil, mais les données brutes 0xA8 = 168 secteurs réalloués. Le disque commence à se dégrader : surveillance rapprochée et sauvegarde immédiate.
3. Valeurs normalisées vs données brutes
C’est la principale source de confusion dans une interprétation.
Les valeurs normalisées (Actuelle / Pire / Seuil)
- Calculées par le firmware du disque à partir des données brutes, selon une formule propre au fabricant et en général non publiée.
- Valeur de départ typique : 100, 200 ou 253 (cette dernière signifie en général « jamais utilisé ou pas pas encore évalué »).
- Elles servent uniquement à la comparaison avec le seuil. Une valeur de 100 ne veut pas forcément dire « 100 % ».
Les données brutes (Raw)
- Ce sont les vrais compteurs. Pour les attributs les plus importants (05, C5, C6, 09, C2…), ce sont elles qu’il faut regarder.
- Elles sont stockées sur 6 octets (48 bits). Certains fabricants peuvent y empiler plusieurs informations comme par exeple température actuelle + min + max.
Convertir l’hexadécimal en décimal
Le logiciel CrystalDiskInfo affiche les données brutes en hexadécimal par défaut. Il y a 2 solutions pour avoir les données en décimal :
- Changer l’affichage : menu Fonction → Avancé → Format des données brutes → 10 [DEC].
- Convertir à la main : la calculatrice Windows en mode Programmeur.
|
Hexadécimal |
Décimal |
|
00000000000A |
10 |
|
000000000064 |
100 |
|
0000000003E8 |
1 000 |
|
000000002710 |
10 000 |
4. L’état de santé global
Dans le logiciel CrystalDiskInfo
|
Couleur |
État |
Signification |
|
🔵 Bleu |
Bon |
Aucun problème détecté. |
|
🟡 Jaune |
Prudence |
Au moins un attribut critique a des données brutes non nulles (par défaut : 05, C5 ou C6), ou un SSD approche de sa fin de vie. Le disque fonctionne, mais sauvegardez. |
|
🔴 Rouge |
Mauvais |
Un attribut est passé sous son seuil, ou le disque signale lui-même un échec S.M.A.R.T. Remplacement à prévoir rapidement. |
|
⚪ Gris |
Inconnu |
Le logiciel n’arrive pas à lire les données (adaptateur USB, contrôleur RAID…). |
Le pourcentage de « santé » affiché (ex. Bon 98 %) n’est pas une donnée du disque : c’est un calcul du logiciel. Pour les SSD, il provient généralement de l’attribut d’usure (E7, E9, B1, CA ou Percentage Used en NVMe). Chaque logiciel a sa propre formule : Hard Disk Sentinel, par exemple, est beaucoup plus sévère que CrystalDiskInfo.
Statut S.M.A.R.T. global du disque
- Le disque renvoie un verdict simple : PASSED (OK) ou FAILED (au moins un attribut Pre-fail sous son seuil). Un « PASSED » ne garantit rien ; un « FAILED » doit être pris très au sérieux.
5. Les attributs critiques à surveiller en priorité
Voici les lignes les plus importantes et à regarder en priorité. Les statistiques publiées sur de grands parcs de disques (notamment par l’hébergeur Backblaze) montrent que ce sont les meilleurs indicateurs de panne.
|
ID hex |
ID déc |
Attribut |
Données brutes idéales |
Inquiétant si… |
|
05 |
5 |
Secteurs réalloués |
|
> 0, et surtout s’il augmente |
|
C5 |
197 |
Secteurs en attente de réallocation |
|
> 0 |
|
C6 |
198 |
Secteurs non corrigibles hors-ligne |
|
> 0 |
|
BB |
187 |
Erreurs non corrigibles signalées |
|
> 0 |
|
BC |
188 |
Expiration de commandes |
|
augmente régulièrement |
|
C4 |
196 |
Événements de réallocation |
|
> 0 et en hausse |
|
0A |
10 |
Tentatives de rotation |
|
> 0 (problème mécanique) |
|
B8 |
184 |
Erreurs de bout en bout |
|
> 0 |
|
C7 |
199 |
Erreurs CRC Ultra DMA |
|
augmente → câble ou connecteur, pas forcément le disque |
|
C2 |
194 |
Température |
25–45 °C (HDD) |
> 50 °C (HDD) / > 70 °C (SSD) |
Règle d’or : une valeur non nulle isolée et stable dans le temps est moins inquiétante qu’une valeur qui augmente, même lentement. Il est conseillé de relever les valeurs régulièrement et de les comparer d’une semaine à l’autre.
6. Dictionnaire des attributs – disques durs HDD
Le tableau suivant donne la signification des principaux attributs. Les noms des attributs peuvent varier légèrement de ceux des tableaux précédents (par exemple ceux du §2).
Légende de la colonne Gravité : 🔴 critique · 🟠 à surveiller · 🟢 informatif
|
ID hex |
ID déc |
Nom anglais |
Nom français |
Signification et interprétation |
Gravité |
|
01 |
1 |
Raw Read Error Rate |
Taux d’erreurs de lecture brutes |
Erreurs survenues lors de la lecture physique des données. Chez Seagate, les données brutes sont énormes et c’est normal (compteur composite). Ne regardez que la valeur normalisée vs le seuil. Chez WD/Toshiba/HGST, la valeur brute devrait être 0 ou proche. |
🟠 |
|
02 |
2 |
Throughput Performance |
Performance de débit |
Efficacité globale du disque. Une baisse de la valeur normalisée indique une dégradation. |
🟢 |
|
03 |
3 |
Spin-Up Time |
Temps de démarrage du moteur |
Temps (ms) pour que les plateaux atteignent leur vitesse. Une hausse importante peut indiquer un moteur ou des roulements fatigués. |
🟠 |
|
04 |
4 |
Start/Stop Count |
Nombre de démarrages/arrêts |
Nombre de cycles de rotation des plateaux. Purement informatif (usure). |
🟢 |
|
05 |
5 |
Reallocated Sectors Count |
Secteurs réalloués |
Nombre de secteurs défectueux que le disque a remplacés par des secteurs de réserve. Idéal : 0. Quelques unités stables : surveiller. Une croissance continue : le disque se dégrade, remplacement conseillé. Quand la réserve est épuisée, les données sont perdues. |
🔴 |
|
06 |
6 |
Read Channel Margin |
Marge du canal de lecture |
Marge du signal de lecture. Rarement utilisé. |
🟢 |
|
07 |
7 |
Seek Error Rate |
Taux d’erreurs de positionnement |
Erreurs de positionnement des têtes. Chez Seagate, valeur brute énorme normale (composite). Ailleurs, devrait rester à 0. |
🟠 |
|
08 |
8 |
Seek Time Performance |
Performance de positionnement |
Temps moyen de positionnement. Une baisse peut signaler un problème mécanique. |
🟢 |
|
09 |
9 |
Power-On Hours |
Heures de fonctionnement |
Durée totale sous tension. Utile pour connaître l’âge réel (ex. un disque « neuf » avec 15 000 h ne l’est pas). Repère : 8 760 h = 1 an en continu. Certains disques comptent en minutes ou demi-minutes. |
🟢 |
|
0A |
10 |
Spin Retry Count |
Tentatives de rotation |
Nombre de fois où le moteur a dû réessayer pour atteindre sa vitesse. > 0 = problème mécanique ou d’alimentation. |
🔴 |
|
0B |
11 |
Recalibration Retries |
Tentatives de recalibrage |
Nombre de recalibrages des têtes nécessaires. Une hausse indique un souci mécanique. |
🟠 |
|
0C |
12 |
Power Cycle Count |
Nombre de mises sous tension |
Nombre total d’allumages. Informatif. |
🟢 |
|
0D |
13 |
Soft Read Error Rate |
Erreurs de lecture logicielles |
Erreurs de lecture corrigées par le firmware. |
🟠 |
|
16 |
22 |
Current Helium Level |
Niveau d’hélium |
Disques remplis d’hélium (WD/HGST grande capacité). La valeur normalisée doit rester à 100 ; une baisse = fuite. |
🔴 |
|
B7 |
183 |
SATA Downshift Error Count / Runtime Bad Block |
Rétrogradations SATA / blocs défectueux |
Selon le fabricant : nombre de fois où la liaison SATA a dû baisser de vitesse, ou blocs défectueux détectés en fonctionnement. |
🟠 |
|
B8 |
184 |
End-to-End Error |
Erreurs de bout en bout |
Incohérence de données détectée entre le cache et les plateaux. > 0 = problème du disque. |
🔴 |
|
BB |
187 |
Reported Uncorrectable Errors |
Erreurs non corrigibles signalées |
Erreurs que le code correcteur (ECC) n’a pas pu réparer. > 0 = données potentiellement perdues. |
🔴 |
|
BC |
188 |
Command Timeout |
Expiration de commandes |
Commandes interrompues faute de réponse. Peut venir du disque, mais aussi de l’alimentation ou du câble. Surveillez son évolution. |
🟠 |
|
BD |
189 |
High Fly Writes |
Écritures en vol haut |
La tête d’écriture volait trop haut au-dessus du plateau (choc, vibrations). Des valeurs faibles sont fréquentes ; une hausse rapide est mauvaise. |
🟠 |
|
BE |
190 |
Airflow Temperature |
Température du flux d’air |
Température interne. Sur certains disques, la valeur normalisée vaut 100 − température (ex. 65 → 35 °C). |
🟠 |
|
BF |
191 |
G-Sense Error Rate |
Erreurs de choc |
Nombre de chocs ou vibrations détectés. Fréquent sur les portables. Informatif sauf hausse importante. |
🟢 |
|
C0 |
192 |
Power-off Retract Count |
Rétractions d’urgence |
Nombre de coupures brutales de courant (têtes rétractées en urgence). Une valeur élevée indique des extinctions forcées répétées. |
🟢 |
|
C1 |
193 |
Load/Unload Cycle Count |
Cycles de chargement/déchargement |
Nombre de fois où les têtes ont été parquées. Les disques sont prévus pour 300 000 à 600 000 cycles. Une hausse très rapide (plusieurs centaines par jour) vient souvent d’une gestion d’énergie trop agressive (fréquent sur WD Green). |
🟠 |
|
C2 |
194 |
Temperature |
Température |
Température actuelle en °C. Les données brutes contiennent souvent aussi la température min et max (voir §9). HDD idéal : 25–45 °C. Au-delà de 50 °C de façon durable, la durée de vie diminue. |
🟠 |
|
C3 |
195 |
Hardware ECC Recovered |
Erreurs corrigées par ECC |
Erreurs corrigées par le matériel. Valeurs brutes souvent élevées et normales (surtout Seagate). |
🟢 |
|
C4 |
196 |
Reallocation Event Count |
Événements de réallocation |
Nombre d’opérations de réallocation (réussies ou non). Va de pair avec l’attribut 05. |
🔴 |
|
C5 |
197 |
Current Pending Sector Count |
Secteurs en attente |
Secteurs instables que le disque n’a pas pu lire et qui attendent d’être réalloués. Le plus inquiétant au quotidien : les données de ces secteurs sont peut-être illisibles. Si le secteur est réécrit avec succès, le compteur peut redescendre à 0 ; sinon il est réalloué (et l’attribut 05 augmente). |
🔴 |
|
C6 |
198 |
Offline Uncorrectable |
Non corrigibles hors-ligne |
Secteurs illisibles détectés lors des tests hors-ligne. > 0 = surface du disque endommagée. |
🔴 |
|
C7 |
199 |
UltraDMA CRC Error Count |
Erreurs CRC Ultra DMA |
Erreurs de transmission entre le disque et la carte mère. Indique presque toujours un problème de câble SATA, de connecteur ou d’adaptateur, pas du disque lui-même. Ce compteur ne redescend jamais : vérifiez seulement qu’il n’augmente plus après changement du câble. |
🟠 |
|
C8 |
200 |
Write Error Rate / Multi-Zone Error Rate |
Taux d’erreurs d’écriture |
Erreurs lors de l’écriture. Une hausse signale une dégradation de surface ou des têtes. |
🟠 |
|
DC |
220 |
Disk Shift |
Décalage des plateaux |
Décalage physique des plateaux par rapport à l’axe (après un choc). |
🔴 |
|
DF |
223 |
Load/Unload Retry Count |
Tentatives de chargement des têtes |
Nombre de nouvelles tentatives de chargement des têtes. |
🟠 |
|
E0 |
224 |
Load Friction |
Friction au chargement |
Friction mécanique lors du chargement des têtes. |
🟠 |
|
E2 |
226 |
Load-in Time |
Durée de chargement |
Temps de chargement des têtes. |
🟢 |
|
F0 |
240 |
Head Flying Hours |
Heures de vol des têtes |
Temps pendant lequel les têtes ont été en position de travail. |
🟢 |
|
F1 |
241 |
Total LBAs Written |
Total écrit |
Volume total écrit (généralement en secteurs de 512 octets). |
🟢 |
|
F2 |
242 |
Total LBAs Read |
Total lu |
Volume total lu. |
🟢 |
|
FE |
254 |
Free Fall Protection |
Protection contre les chutes |
Nombre de chutes détectées (portables). |
🟢 |
7. Dictionnaire des attributs – SSD SATA
Un SSD n’a ni plateaux ni têtes : les attributs mécaniques n’existent pas. Ce qui compte, c’est l’usure de la mémoire flash (chaque cellule supporte un nombre limité d’écritures) et la réserve de blocs de remplacement.
Les numéros d’attribut des SSD sont varient sensiblement selon les marques. Seul le nom affiché par le logiciel est à prendre en compte.
|
ID hex |
ID déc |
Nom anglais |
Signification et interprétation |
Gravité |
|
05 |
5 |
Reallocated Sector / Retired Block Count |
Blocs de flash retirés et remplacés. Idéal : 0. Une hausse indique une usure ou un défaut de la mémoire. |
🔴 |
|
09 |
9 |
Power-On Hours |
Heures de fonctionnement. |
🟢 |
|
0C |
12 |
Power Cycle Count |
Nombre de mises sous tension. |
🟢 |
|
A9 |
169 |
Remaining Life |
Durée de vie restante (certains modèles). |
🟠 |
|
AA |
170 |
Available Reserved Space / Grown Bad Blocks |
Espace de réserve disponible, ou nombre de blocs défectueux apparus. |
🔴 |
|
AB |
171 |
Program Fail Count |
Échecs d’écriture dans la flash. Devrait rester à 0. |
🔴 |
|
AC |
172 |
Erase Fail Count |
Échecs d’effacement de blocs. Devrait rester à 0. |
🔴 |
|
AD |
173 |
Average Erase Count / Wear Leveling |
Nombre moyen d’effacements par bloc. À comparer à l’endurance théorique de la flash (environ 1 000 à 3 000 cycles en TLC, moins en QLC). |
🟠 |
|
AE |
174 |
Unexpected Power Loss Count |
Coupures de courant brutales. Les SSD y sont plus sensibles que les HDD. |
🟢 |
|
B1 |
177 |
Wear Leveling Count (Samsung) |
Indicateur d’usure Samsung. La valeur normalisée part de 100 et descend : c’est le % de vie restante. |
🟠 |
|
B3 |
179 |
Used Reserved Block Count |
Blocs de réserve déjà consommés (Samsung). |
🔴 |
|
B4 |
180 |
Unused Reserved Block Count |
Blocs de réserve encore disponibles. Une baisse est mauvaise. |
🔴 |
|
B5 |
181 |
Program Fail Count Total |
Total des échecs d’écriture. |
🔴 |
|
B6 |
182 |
Erase Fail Count Total |
Total des échecs d’effacement. |
🔴 |
|
B7 |
183 |
Runtime Bad Block |
Blocs défectueux apparus en fonctionnement. |
🟠 |
|
BB |
187 |
Reported Uncorrectable Errors |
Erreurs non corrigibles. > 0 = alerte. |
🔴 |
|
C2 |
194 |
Temperature |
Température. Un SSD SATA supporte 0–70 °C ; idéal sous 50 °C. |
🟠 |
|
C3 |
195 |
ECC Error Rate |
Erreurs corrigées par ECC. |
🟢 |
|
C4 |
196 |
Reallocation Event Count |
Événements de réallocation. |
🔴 |
|
C5 |
197 |
Current Pending Sector Count |
Blocs en attente. > 0 = alerte. |
🔴 |
|
C6 |
198 |
Uncorrectable Sector Count |
Secteurs non corrigibles. > 0 = alerte. |
🔴 |
|
C7 |
199 |
UltraDMA CRC Error Count |
Erreurs de câble/connecteur, comme pour les HDD. |
🟠 |
|
CA |
202 |
Percent Lifetime Remaining / Used (Crucial, Micron) |
Indicateur d’usure Crucial. Selon le modèle, les données brutes donnent le % de vie consommé. |
🟠 |
|
CE |
206 |
Flying Height / Write Error Rate |
Selon le fabricant. |
🟠 |
|
E6 |
230 |
Drive Life Protection Status |
État de protection de fin de vie. |
🟠 |
|
E7 |
231 |
SSD Life Left |
Vie restante du SSD en %, valeur normalisée de 100 à 0 (Kingston, SandForce, etc.). |
🟠 |
|
E8 |
232 |
Available Reserved Space |
Réserve disponible en % (Intel). Alerte si proche du seuil. |
🔴 |
|
E9 |
233 |
Media Wearout Indicator / NAND Writes |
Intel : usure, valeur normalisée de 100 à 1. D’autres marques : volume total écrit dans la flash. |
🟠 |
|
EA |
234 |
Average/Max Erase Count |
Nombre moyen ou maximal d’effacements. |
🟢 |
|
F1 |
241 |
Total LBAs Written / Host Writes |
Volume total écrit par l’ordinateur. L’unité varie : secteurs de 512 octets (Samsung, Crucial…), blocs de 32 Mo (Intel), Go (Kingston…). CrystalDiskInfo le convertit dans le champ « Écritures totales ». |
🟢 |
|
F2 |
242 |
Total LBAs Read / Host Reads |
Volume total lu. |
🟢 |
|
F9 |
249 |
NAND Writes (1 GiB) |
Volume réellement écrit dans la flash (inclut l’amplification d’écriture). |
🟢 |
|
FA |
250 |
Read Error Retry Rate |
Nouvelles tentatives de lecture. |
🟠 |
Estimer la durée de vie restante d’un SSD
Pour estimer la durée de vie d'un SSD
- Repérez le TBW (TeraBytes Written, endurance garantie) dans la fiche technique du modèle (ex. 600 To pour un SSD de 1 To grand public).
- Lisez les écritures totales (F1, F9 ou le champ « Écritures totales » de CrystalDiskInfo).
- Usure ≈ écritures totales ÷ TBW.
Exemple : 45 To écrits sur un TBW de 600 To → environ 7,5 % de l’endurance garantie consommée. En pratique, les SSD dépassent souvent largement leur TBW.
8. Les SSD NVMe : un format différent
Les SSD NVMe (format M.2 PCIe) n’utilisent pas les attributs numérotés. Ils renvoient un journal de santé standardisé, identique pour toutes les marques, c'est la raison pour laquelle il est plus facile à interpréter.
|
Champ |
Signification |
Valeurs normales / alerte |
|
Critical Warning |
Indicateur d’alerte global (bits : réserve faible, température, fiabilité dégradée, lecture seule, sauvegarde mémoire volatile). |
Doit être . Toute autre valeur = problème. |
|
Composite Temperature |
Température du contrôleur. |
Normal jusqu’à ~70 °C sous charge ; au-delà, le SSD ralentit pour se protéger (throttling). |
|
Available Spare |
Réserve de blocs restante, en %. |
100 % neuf. Alerte quand elle approche du seuil. |
|
Available Spare Threshold |
Seuil d’alerte de la réserve (souvent 10 %). |
Si Available Spare < seuil → alerte critique. |
|
Percentage Used |
Pourcentage de l’endurance estimée consommé. |
0 % neuf. Peut dépasser 100 % : le SSD continue souvent de fonctionner, mais hors garantie d’endurance. |
|
Data Units Read |
Volume lu. 1 unité = 512 000 octets (1 000 × 512). |
Informatif. |
|
Data Units Written |
Volume écrit, même unité. |
Informatif ; à comparer au TBW. |
|
Host Read/Write Commands |
Nombre de commandes reçues. |
Informatif. |
|
Controller Busy Time |
Temps d’activité du contrôleur (minutes). |
Informatif. |
|
Power Cycles |
Nombre de mises sous tension. |
Informatif. |
|
Power On Hours |
Heures de fonctionnement. |
Informatif. |
|
Unsafe Shutdowns |
Coupures non propres. |
Informatif ; une valeur élevée signale des extinctions brutales. |
|
Media and Data Integrity Errors |
Erreurs d’intégrité non corrigées. |
Doit être 0. > 0 = problème réel. |
|
Number of Error Information Log Entries |
Entrées dans le journal d’erreurs. |
Souvent non nul sans gravité (commandes non supportées envoyées par le système). À relativiser. |
|
Warning / Critical Composite Temperature Time |
Minutes passées au-dessus des seuils de température. |
Idéalement 0 ; une valeur élevée = refroidissement insuffisant. |
Dans CrystalDiskInfo, ces champs NVMe apparaissent quand même avec des « ID » (01, 02, 03…), mais ce sont de simples numéros de ligne, sans rapport avec les attributs SATA du même numéro.
9. Cas particuliers et points d'attention
Seagate : des valeurs brutes gigantesques en 01, 07 et C3
- Sur les disques de la marque Seagate, les attributs 01 (Raw Read Error Rate), 07 (Seek Error Rate) et C3 (Hardware ECC Recovered) affichent des données brutes énormes, du type 00000A3F2C18. Ce n'est pas une erreur car ces compteurs sont composites (nombre d’erreurs + nombre total d’opérations). Seule la valeur normalisée comparée au seuil a un sens.
Température codée dans les données brutes (C2)
- Exemple : 00320012002A. Le fabricant empile plusieurs températures : - 2 derniers octets 2A = 42 °C (température actuelle) - 12 = 18 °C (minimum enregistré) - 32 = 50 °C (maximum enregistré)
- Le logiciel affiche normalement la température actuelle correctement ailleurs dans l’interface.
Les secteurs en attente (C5) qui disparaissent
- Un secteur en attente peut redevenir sain s’il est réécrit avec succès (formatage complet, écriture de zéros). Le compteur C5 redescend alors. Ce n’est pas une preuve que le disque est guéri : surveillez si cela se reproduit.
Les erreurs CRC (C7) qui ne baissent jamais
- Le compteur C7 est cumulatif. Après avoir changé un câble défectueux, il garde sa valeur ; il faut seulement vérifier qu’il n’augmente plus.
Disques en boîtier USB ou derrière un contrôleur RAID
- La plupart des adaptateurs USB et de contrôleurs RAID ne transmettent pas les données S.M.A.R.T. Le logiciel affiche alors « Inconnu » ou un tableau vide. Branchez le disque directement en SATA pour une lecture fiable.
Valeur normalisée à 253
- Signifie généralement « pas encore évalué » ou « jamais utilisé ». Ce n’est pas une anomalie.
Seuil à 000
- L’attribut est purement informatif : il ne déclenchera jamais d’alerte, quelle que soit sa valeur.
Heures de fonctionnement aberrantes
- Certains modèles comptent en minutes, en demi-minutes ou se réinitialisent après une mise à jour du firmware. Une valeur incohérente avec l’âge du disque n’est pas forcément un signe de panne.
10. Que faire en fonction de la situation affichée ?
|
Situation |
Diagnostic probable |
Action recommandée |
|
Tout à 0 sur 05, C5, C6, BB ; état « Bon » |
Disque sain |
Rien. Contrôle de temps en temps et sauvegardes régulières. |
|
05 > 0 mais stable depuis des mois |
Quelques secteurs défectueux anciens, réserve suffisante |
Sauvegarde, surveillance mensuelle. Ne pas y stocker de données uniques. |
|
05 qui augmente |
Surface ou têtes en dégradation |
Sauvegarde immédiate, remplacement à court terme. |
|
C5 > 0 |
Secteurs illisibles, données potentiellement perdues |
Sauvegarde immédiate. Lancer un test long (test étendu du fabricant ou smartctl -t long). |
|
C6 > 0 ou BB > 0 |
Erreurs non récupérables |
Sauvegarde immédiate, remplacement conseillé. |
|
0A > 0 |
Problème moteur ou alimentation |
Vérifier l’alimentation ; remplacement conseillé si la valeur augmente. |
|
Seul C7 augmente |
Câble SATA, connecteur ou adaptateur défectueux |
Changer le câble ou le port SATA. Le disque est probablement sain. |
|
BC augmente |
Délais d’attente : disque, alimentation ou câble |
Vérifier câble et alimentation ; surveiller. |
|
C1 augmente très vite |
Parcage des têtes trop fréquent |
Ajuster la gestion d’énergie (ex. outil wdidle3 pour certains WD). |
|
Température > 50 °C (HDD) / > 70 °C (SSD) |
Refroidissement insuffisant |
Améliorer la ventilation, ajouter un dissipateur pour un NVMe. |
|
SSD : vie restante < 10 % ou réserve proche du seuil |
Fin de vie de la flash |
Planifier le remplacement. |
|
NVMe : Critical Warning ≠ 0 |
Alerte du SSD |
Sauvegarde immédiate, puis identifier le bit en cause. |
|
État « Mauvais » / S.M.A.R.T. FAILED |
Panne imminente |
Copier les données en priorité absolue, en limitant l’utilisation du disque. Remplacer. |
Bonnes pratiques
- Notez les valeurs des attributs critiques et comparez-les dans le temps : c’est l’évolution qui compte.
- Lancez périodiquement un test long (outil du fabricant, ou smartctl -t long /dev/sdX sous Linux) : il force la lecture de toute la surface et met à jour les compteurs.
- Dans CrystalDiskInfo, activez l’alerte (Fonction → Fonctions d’alerte) et le démarrage résident pour être prévenu automatiquement.
- En cas de doute, croisez plusieurs logiciels et l’outil officiel du fabricant (SeaTools, WD Dashboard, Samsung Magician, Crucial Storage Executive…).
11. Glossaire
|
Terme |
Définition |
|
Secteur |
Plus petite unité de stockage d’un disque (512 octets ou 4 096 octets). |
|
LBA |
Logical Block Address : adresse logique d’un secteur. « Total LBAs written » = nombre de secteurs écrits. |
|
Réallocation |
Remplacement d’un secteur défectueux par un secteur de réserve, de façon transparente pour le système. |
|
Secteur de réserve |
Secteurs mis de côté en usine pour remplacer ceux qui se dégradent. |
|
ECC |
Error Correcting Code : code permettant de détecter et corriger des erreurs de lecture. |
|
CRC |
Cyclic Redundancy Check : contrôle d’intégrité des données transmises sur le câble. |
|
Pre-fail |
Attribut dont le passage sous le seuil annonce une panne imminente. |
|
Old age |
Attribut lié à l’usure normale. |
|
Valeur normalisée |
Note calculée par le fabricant (souvent sur 100 ou 200), comparée au seuil. |
|
Données brutes |
Compteur réel, non transformé. |
|
TBW |
TeraBytes Written : volume d’écriture garanti par le fabricant d’un SSD. |
|
Usure (wear leveling) |
Technique répartissant les écritures sur toutes les cellules d’un SSD pour l’user uniformément. |
|
Amplification d’écriture |
Le SSD écrit souvent plus de données en interne que ce que l’ordinateur lui envoie. |
|
Throttling |
Ralentissement volontaire d’un SSD pour limiter sa température. |
|
Parcage des têtes |
Mise des têtes de lecture en position de repos hors des plateaux. |
|
NVMe |
Protocole des SSD PCIe, avec un journal de santé standardisé au lieu d’attributs numérotés. |
12. Présentation de Smart_Disk_Checker
Document présenté lors de la séance du 17/10/2026.